MeshAnything: Artist-Created Mesh Generation with Autoregressive Transformers
把任意 3D 表示转换成艺术家真正会用的干净、低面数网格。
读博期间,我研究的是 AI 如何通过空间、形状和运动来理解物理世界。
把任意 3D 表示转换成艺术家真正会用的干净、低面数网格。
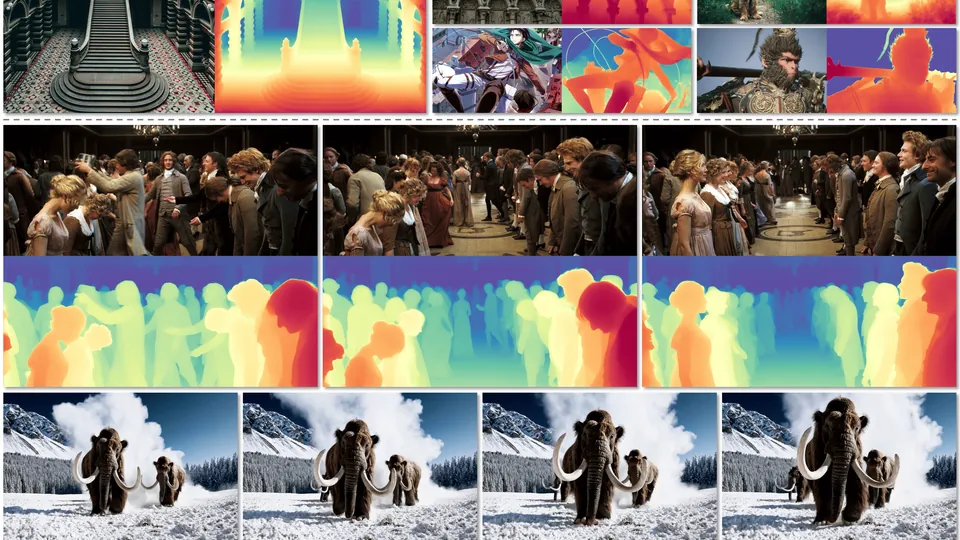
用从游戏引擎采集的 4 万段视频训练,得到时间上一致的视频深度估计。
微调大语言模型,根据文字、姿态或两者结合来生成人体动作。
通过 3D 体渲染,为自动驾驶感知做自监督预训练。
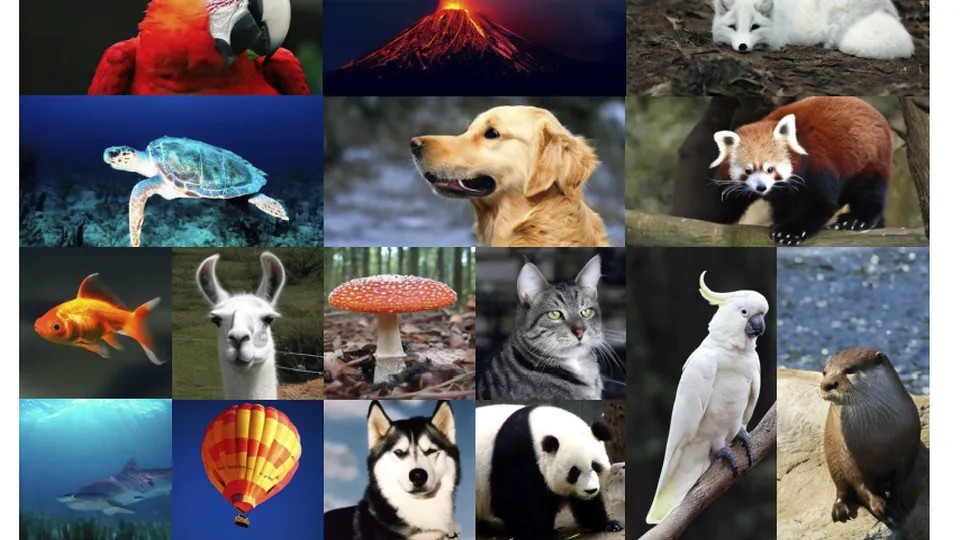
一种能生成任意分辨率和宽高比图像的扩散 Transformer。
用两阶段 SDF 方法,从图像中重建出精细的表面细节。
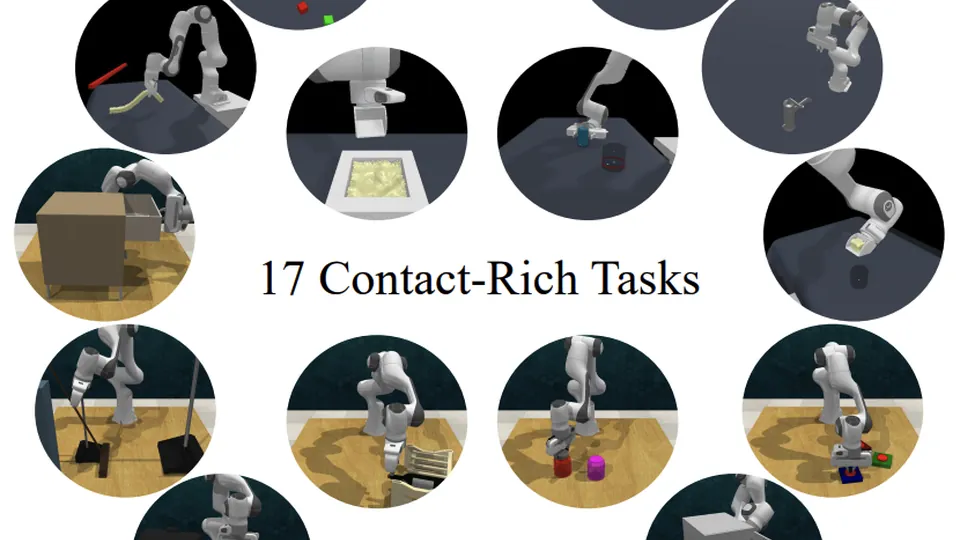
一个包含 125 个任务的基准,比较 RGB、RGB-D 和点云对机器人学习的影响。
借助结构化的体素表示,约 7 秒就能从文字生成 3D 高斯。
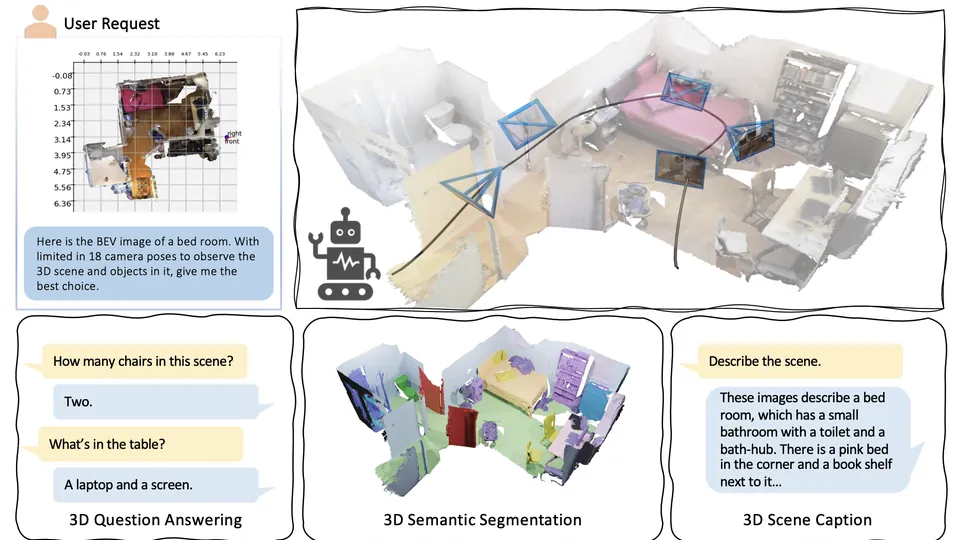
一个视觉语言 Agent,通过自己挑选观察视角来理解 3D 场景。
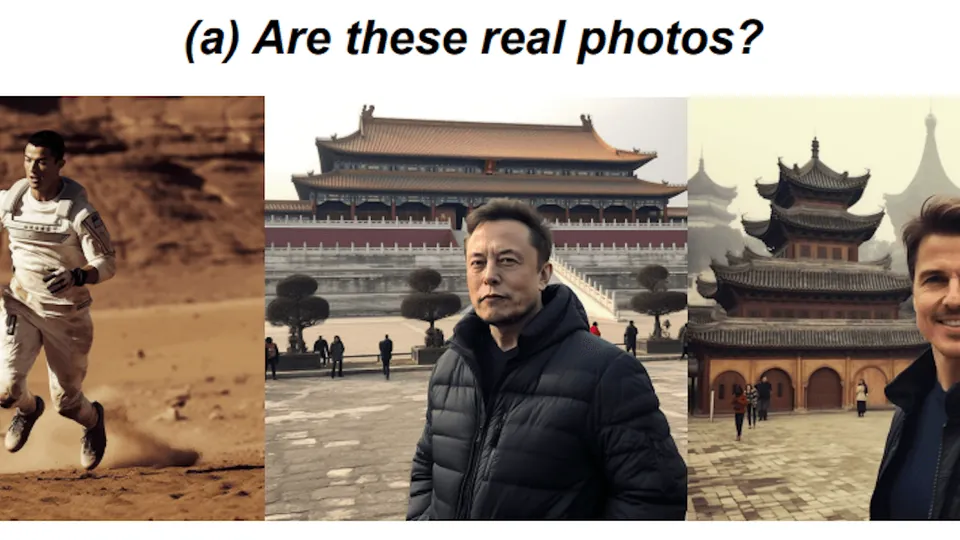
人们判断一张照片是真实拍摄还是 AI 生成时,有 38.7% 的时候会判断错。
把点云特征重新渲染成真实感图像,以此学习点云表示。
把手的运动当作天然的多视角,重建出手中拿着的物体。
只需一段视频扫描就能估计物体位姿,弱纹理物体也适用。
一个开源的无标记人体动作捕捉工具箱,支持单目和多目相机。