1/6 简单整理一下我最近在关注的具身智能模型团队。
我主要关心的是“机器人大脑”,包括模型、数据和训练。
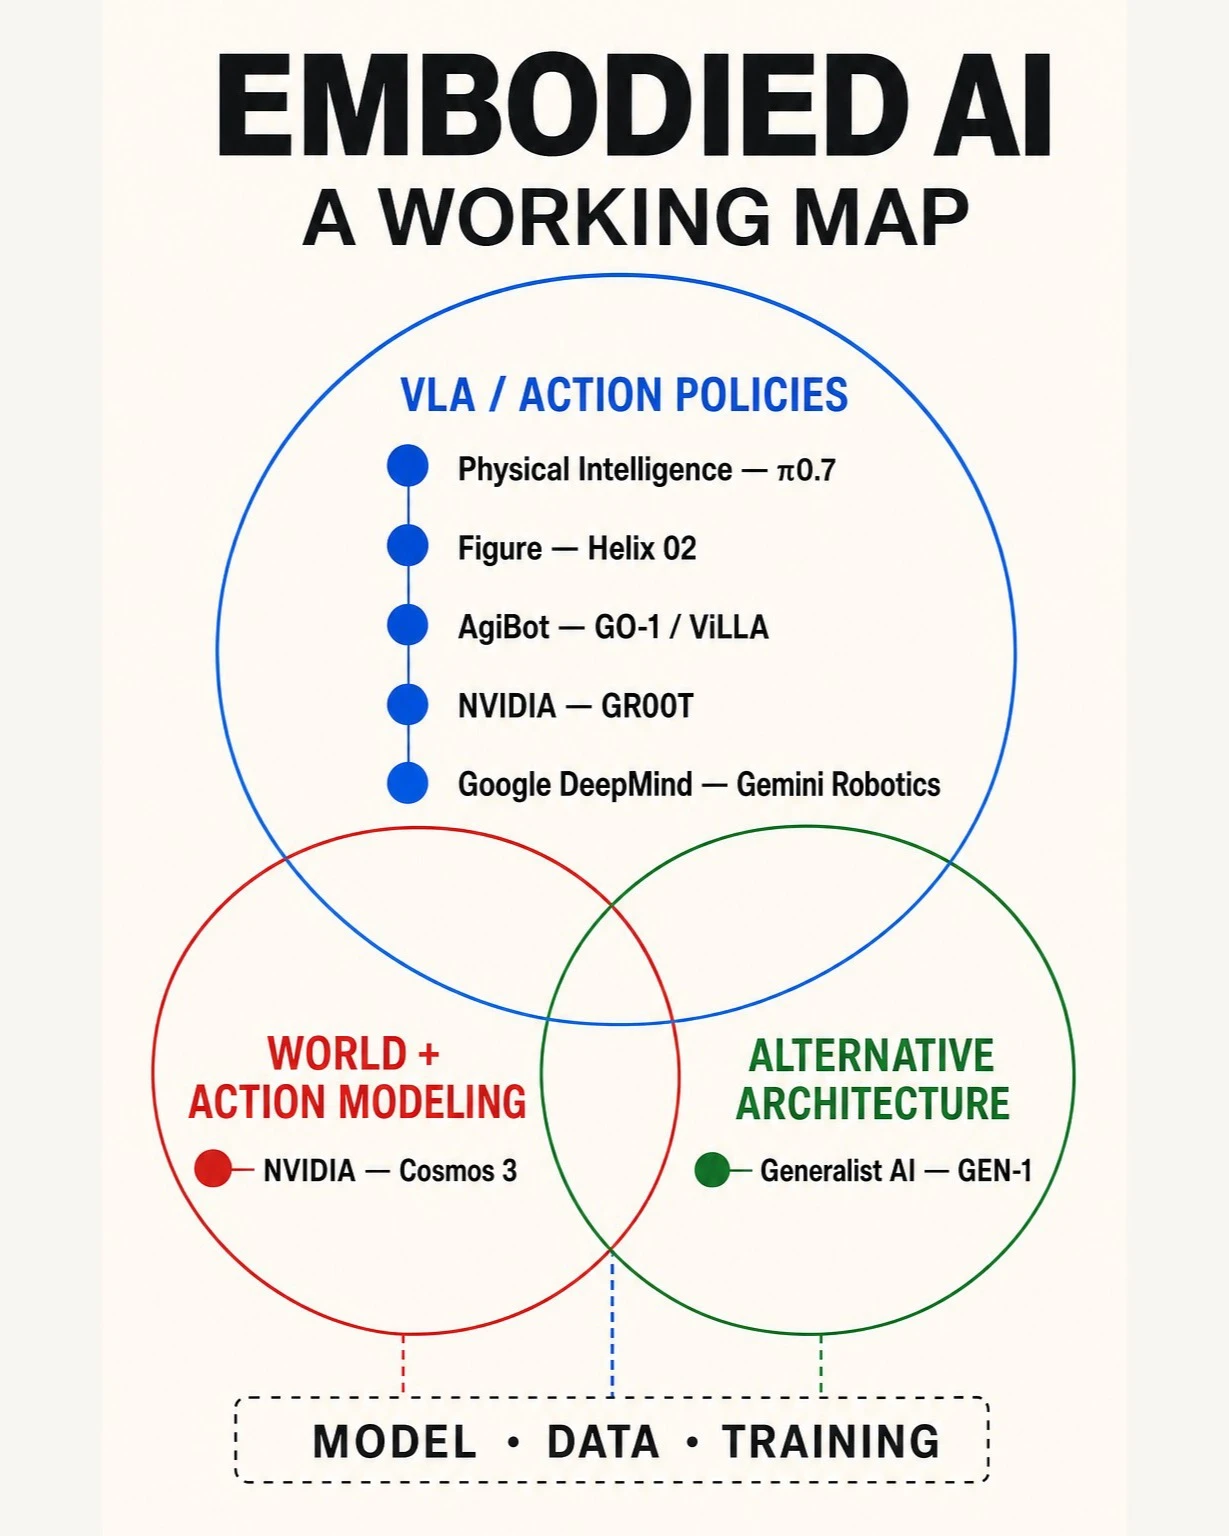
大致分三类:VLA / 动作策略、world-action model,以及其他架构。
2/6 VLA / 动作策略模型:
- Physical Intelligence — π0.7
- Figure — Helix 02
- AgiBot — GO-1 / ViLLA
- NVIDIA — GR00T
- Google DeepMind — Gemini Robotics
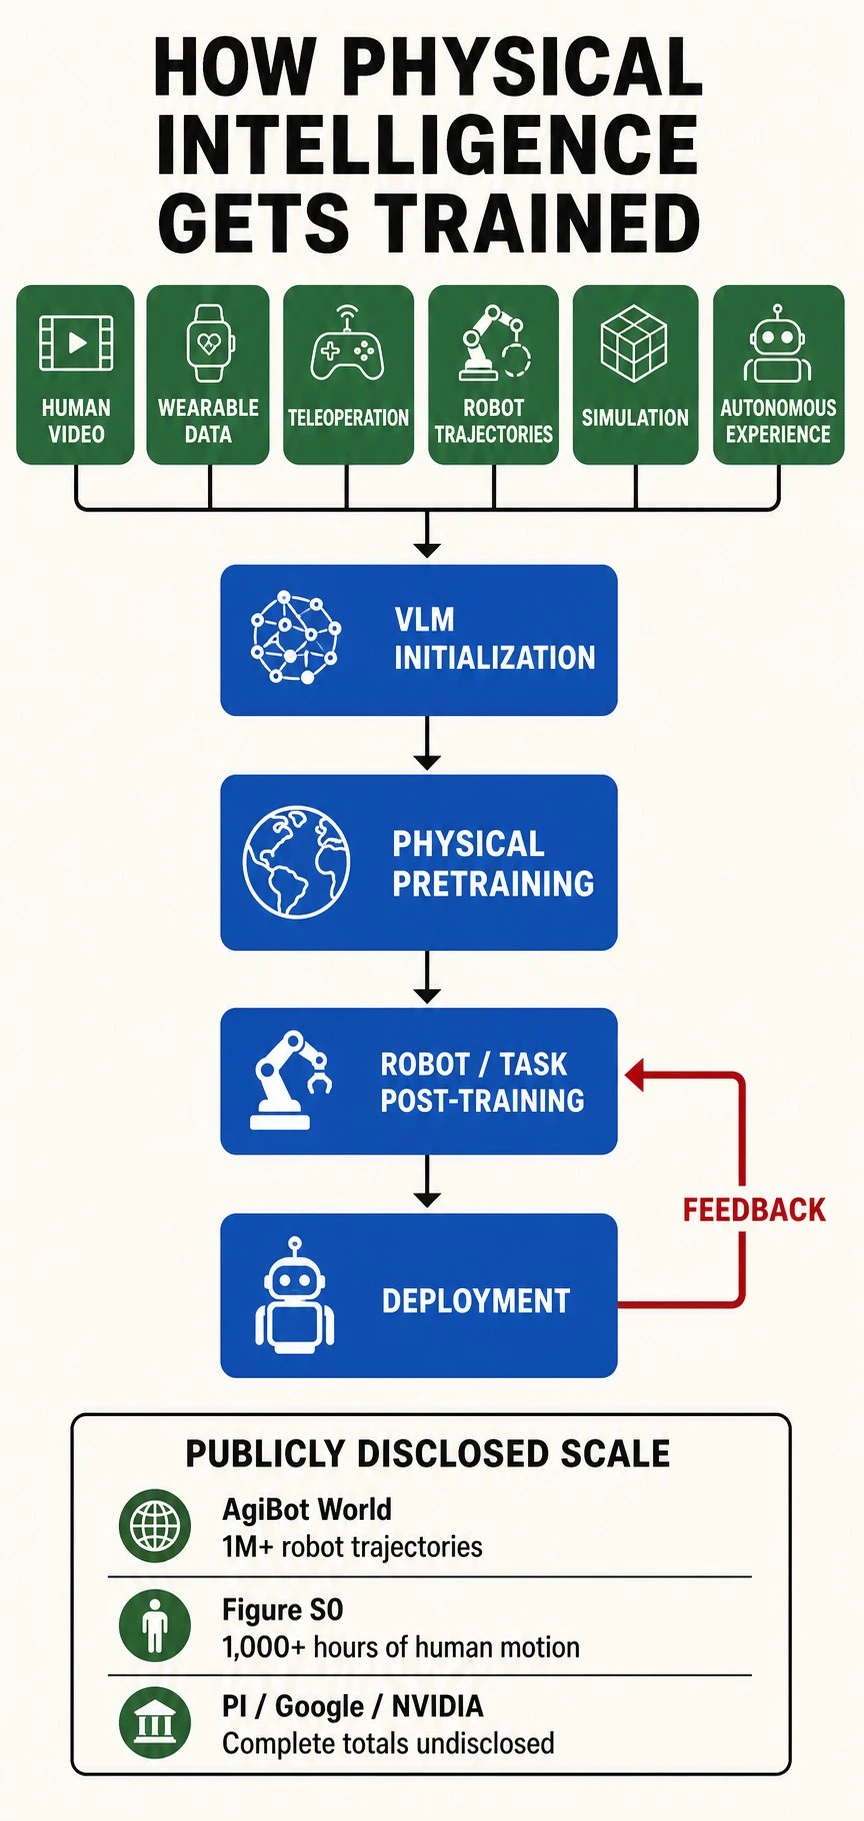
常见的流程:VLM 初始化 → 物理预训练 → 针对机器人 / 任务的后训练 → 部署反馈。
3/6 物理预训练可能会结合人类视频、可穿戴设备数据、遥操作、异构机器人轨迹、仿真和自主经验。
已披露的规模:
- AgiBot World:100 万+ 条机器人轨迹
- Figure S0:1,000+ 小时的人体动作
- PI、Google、NVIDIA:完整总量未披露
4/6 后训练是用示范、纠正、RL 和自主 rollout,把基础模型适配到具体的机器人、任务和环境上。
公开数据有限:
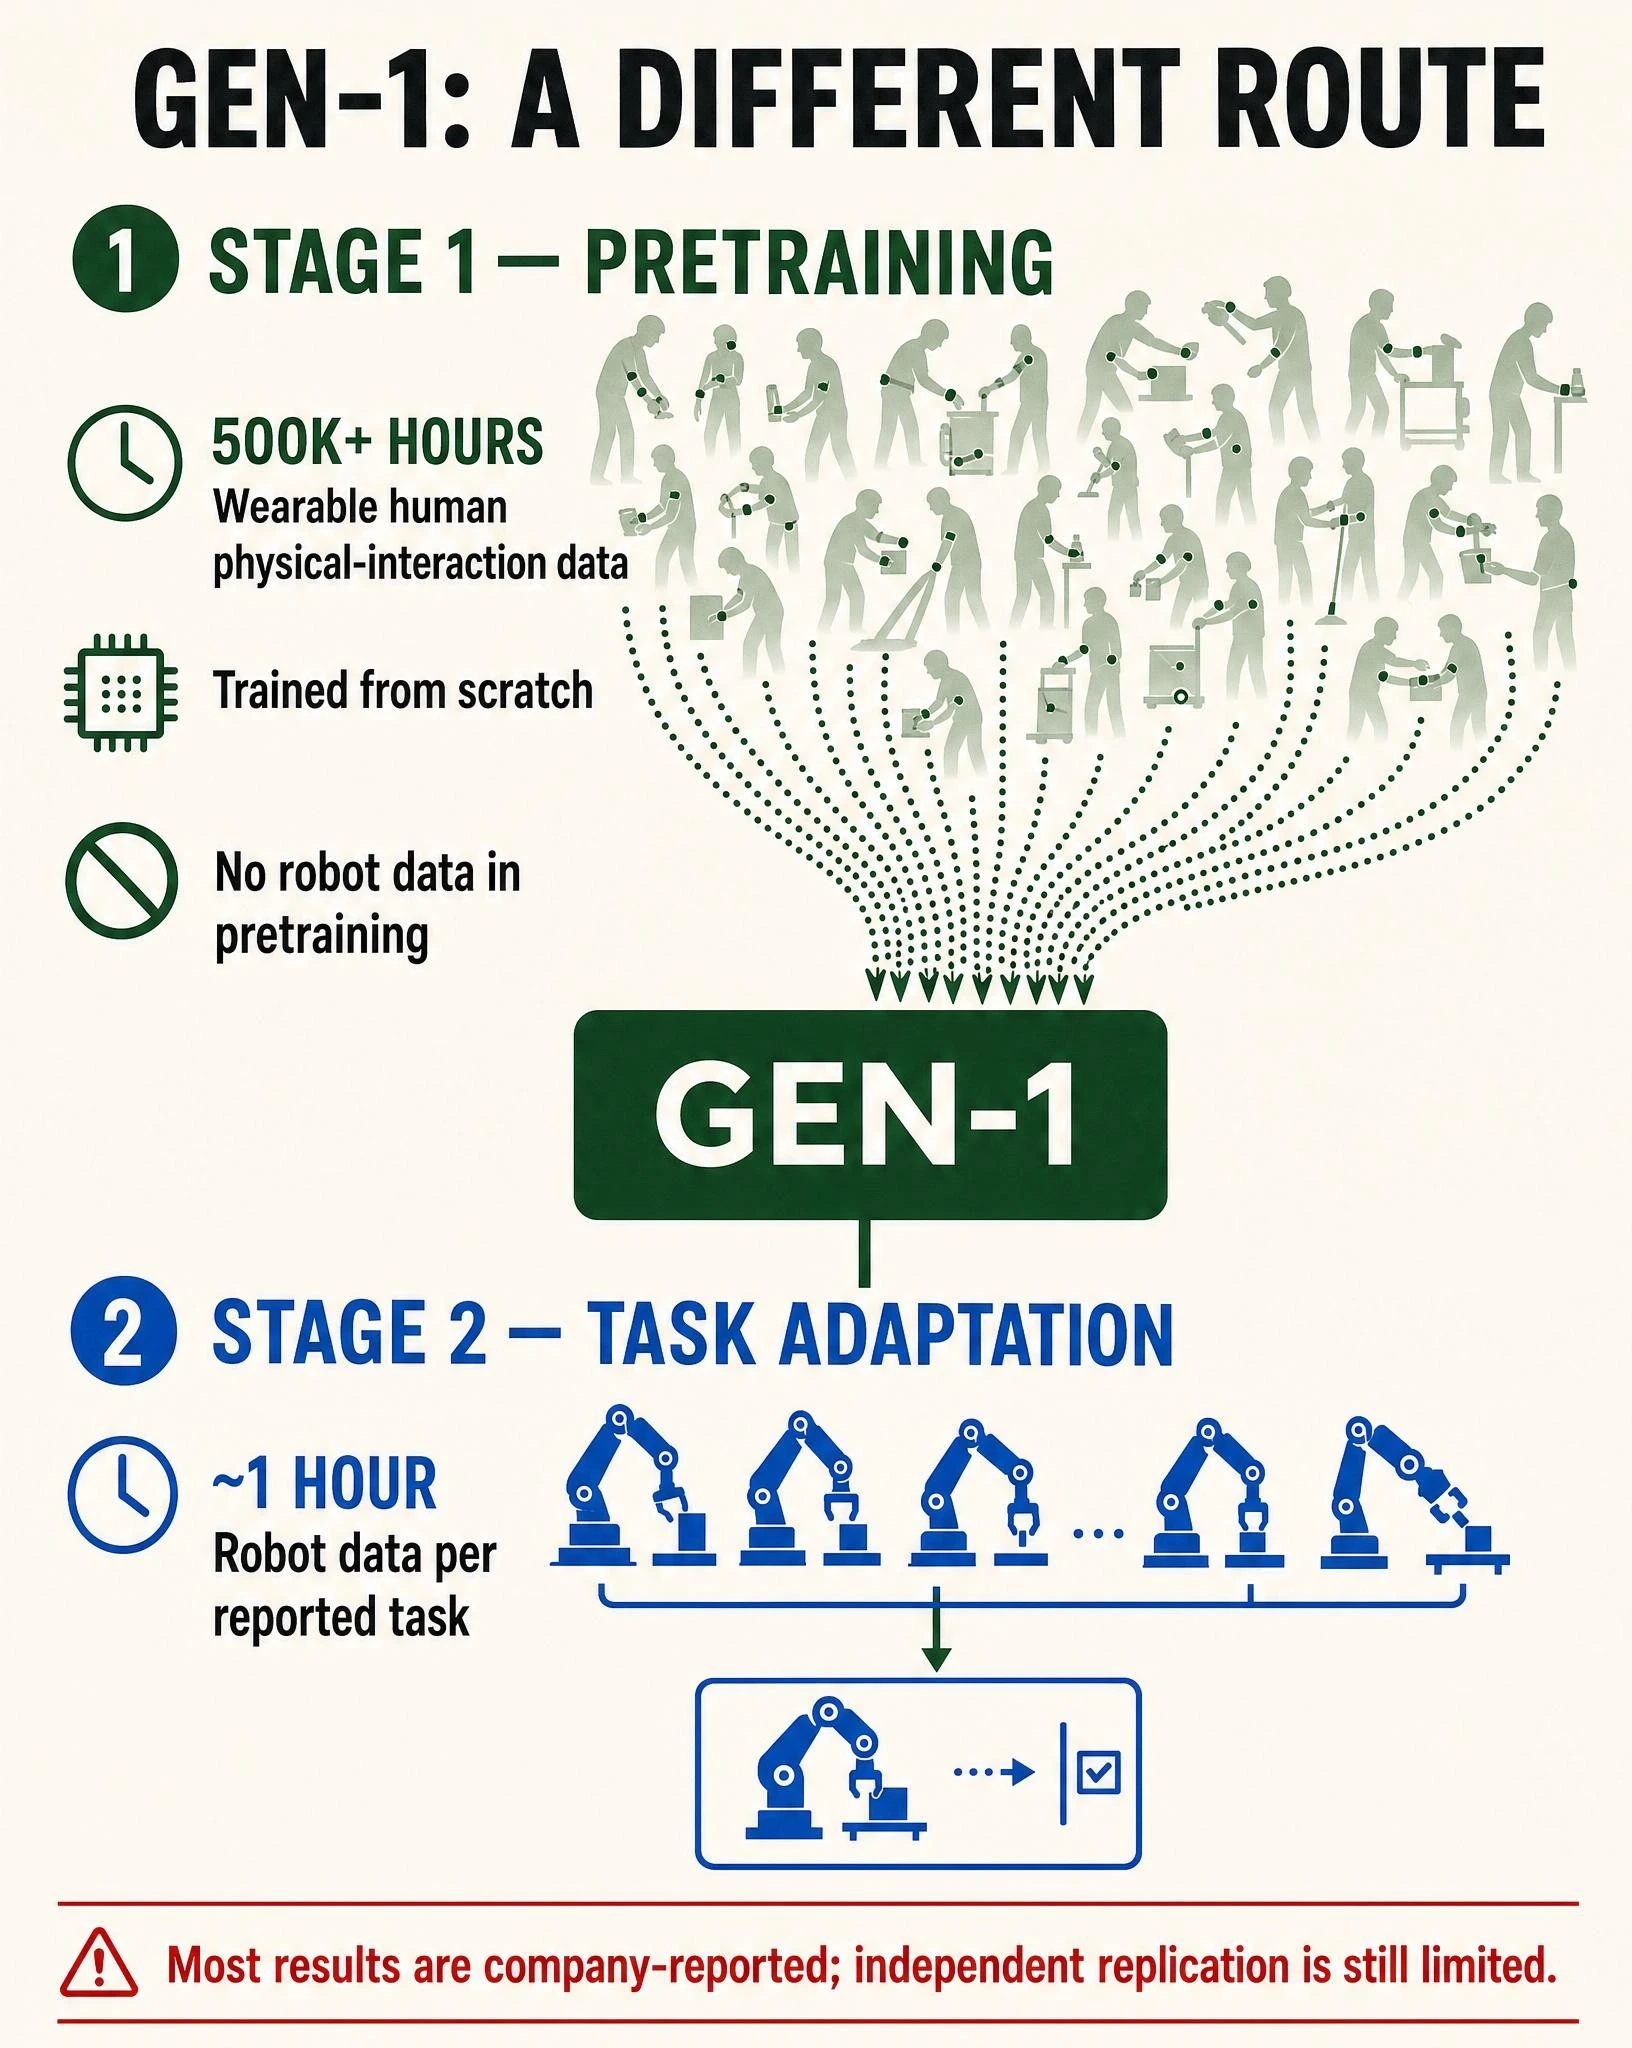
- GEN-1:报告的每个任务约 1 小时
- PI:部分 RL 结果用了几个小时
- 其他大多数:未披露
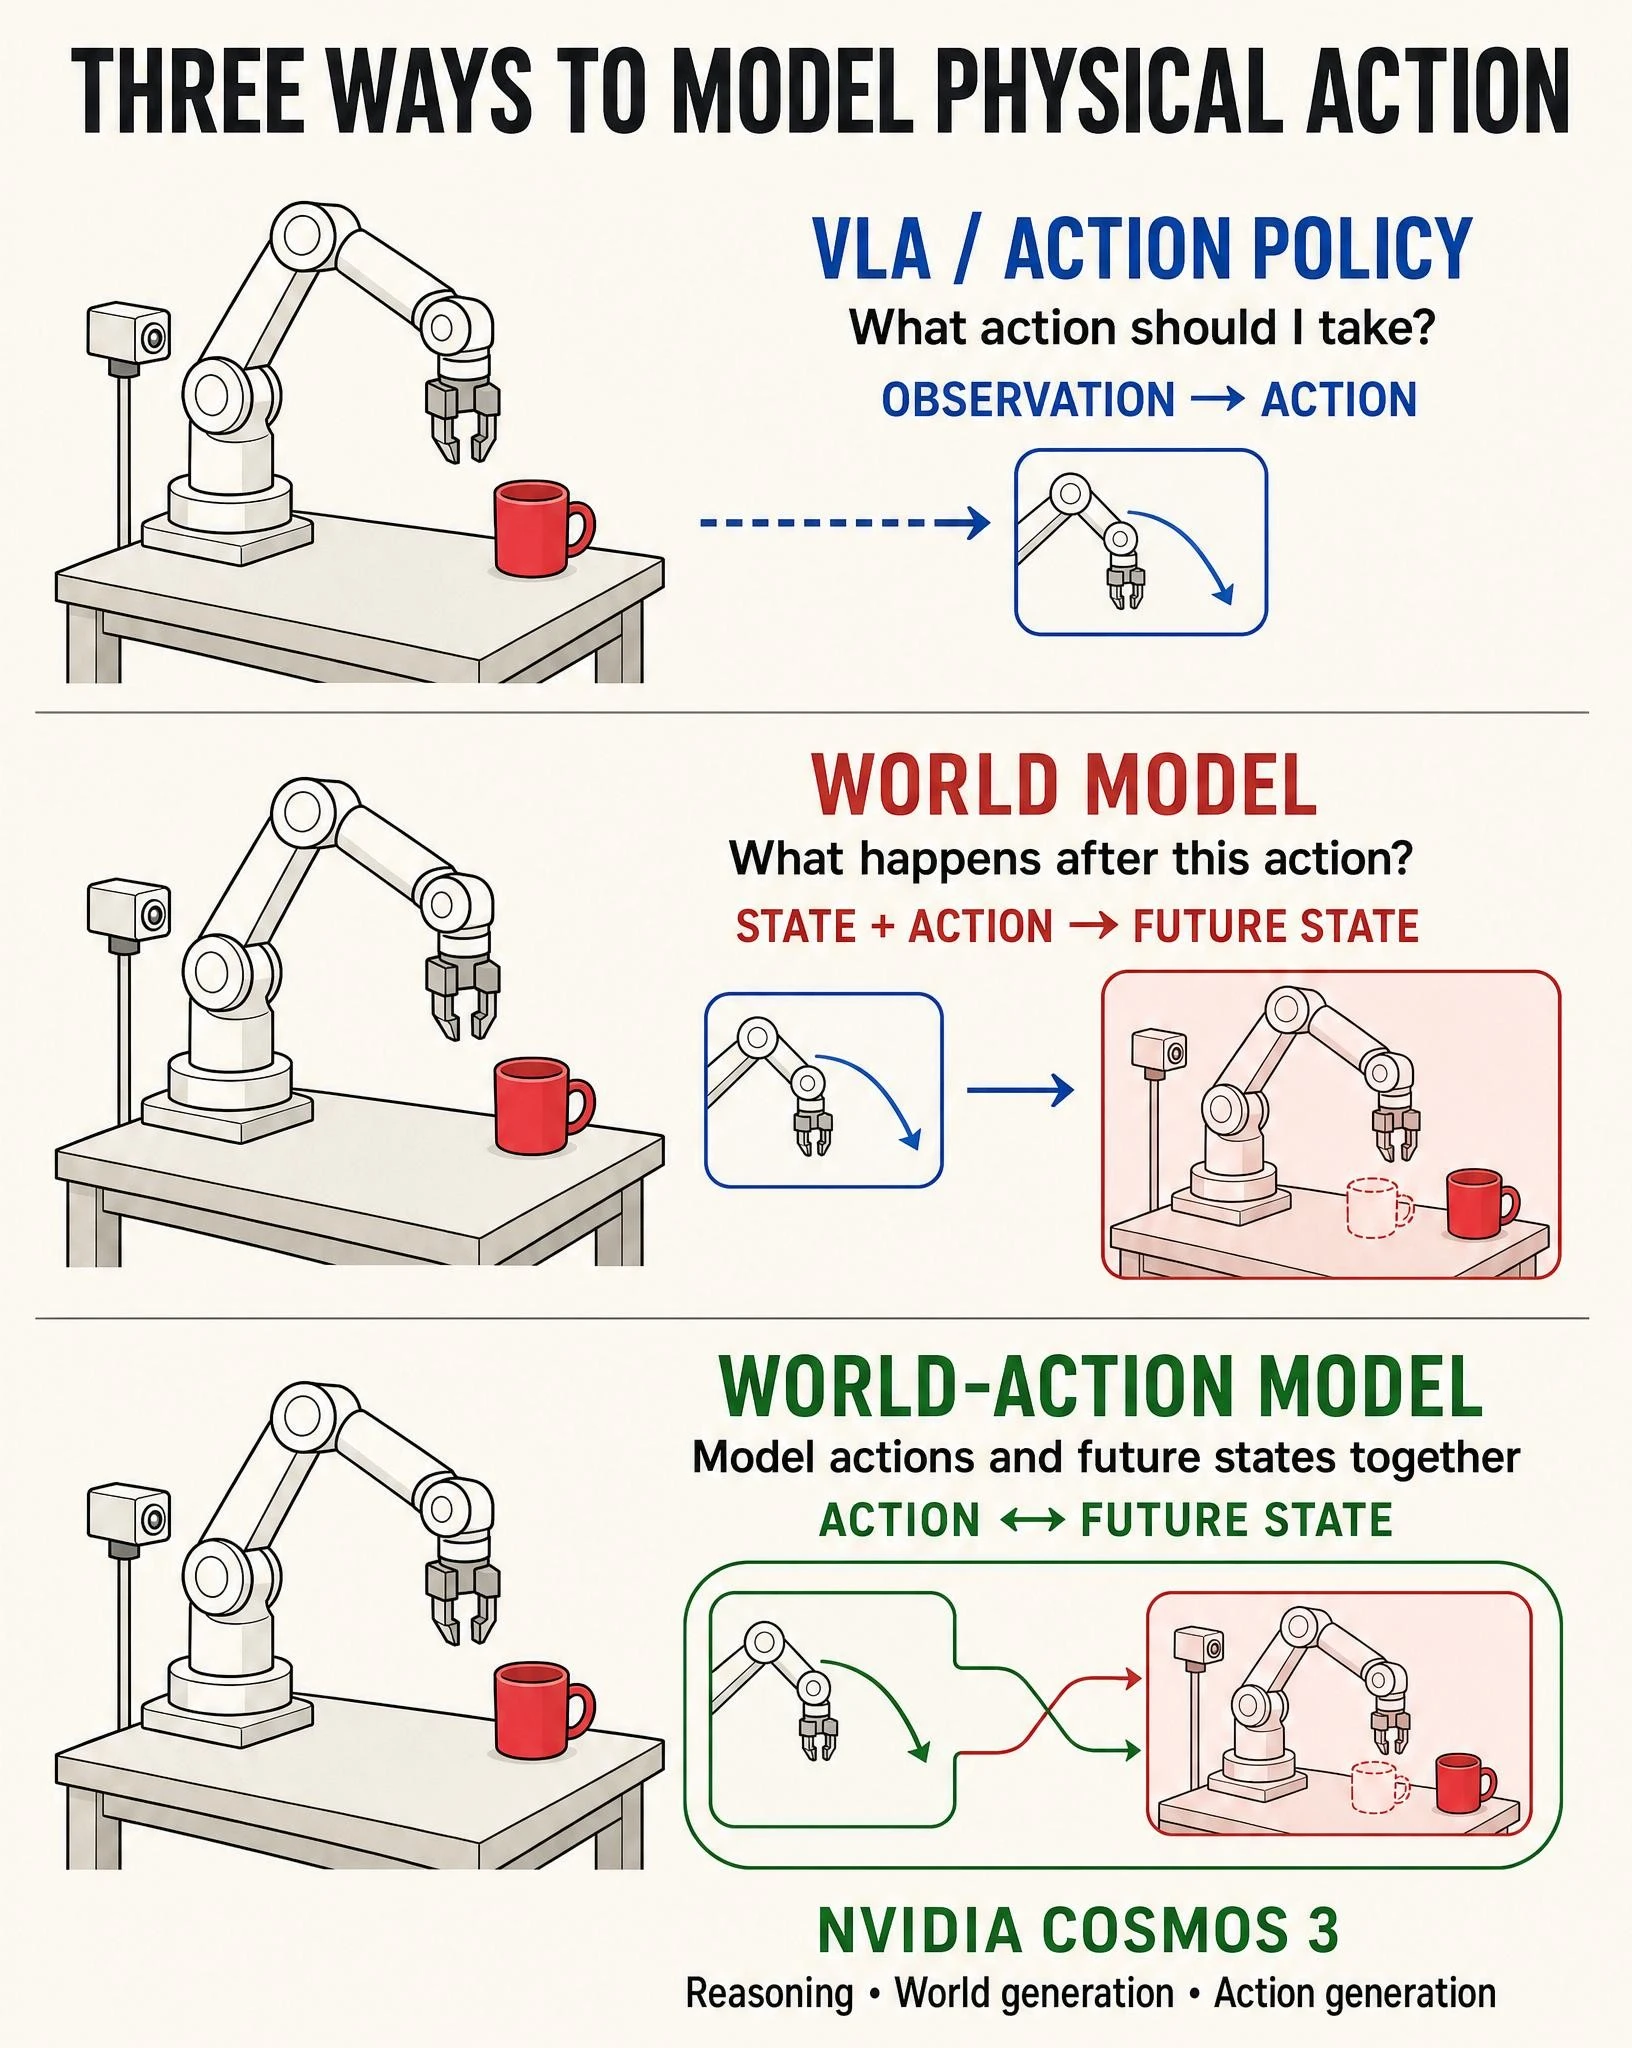
5/6 世界与动作建模:
- NVIDIA — Cosmos 3
VLA:预测该做什么动作。
World model:预测一个动作之后可能发生什么。
WAM:对未来的世界状态和动作联合建模。
Cosmos 3 同时覆盖了推理、世界生成和动作生成,所以这几个类别是有重叠的。
6/6 另一种架构:
- Generalist AI — GEN-1
Generalist 说 GEN-1 是在 50 万+ 小时的可穿戴设备人类物理交互数据上从零训练的,预训练中没有用机器人数据。
在报告的任务上,适配时每个任务用了约 1 小时的机器人数据。
独立验证仍然有限。